


Дальше приятного было мало. Среди нормальных, узнаваемых адресов статей и разделов вперемешку шли строчки, которые не лезли ни в какие ворота — дробь-девять-эф-а-пятьдесят и дальше случайный набор латинских букв и цифр, будто кто-то долбил по клавиатуре с закрытыми глазами. Причём не парой штук, а буквально пачками, экран за экраном одно и то же. Стало не по себе — на сайте я подобного точно не создавал, ни одной такой страницы в глаза не видел.
Первая мысль была, конечно, самая паническая — взлом. Начал прогонять эти адреса через голову: может, где-то завёлся шелл, может, кто-то генерирует спам-страницы прямо на движке, может, дыра в компоненте. Полез разбираться уже с холодной головой, выгрузил весь список в CSV, чтобы было удобнее анализировать, отсортировал по кодам ответа — и вот тут стало чуть спокойнее, потому что абсолютно все эти адреса, кроме одного, отдавали честный четыреста четвёртый. То есть контента там не было и не появилось, сайт физически не пострадал. Но легче от этого было не сильно — потому что вопрос "откуда роботу вообще пришло в голову туда ходить" никуда не делся.
Смотрю на даты — и тут вторая странность. Основная масса этого мусора не размазана равномерно по всей истории сайта, а сконцентрирована в основном на последние месяцы, с явным пиком где-то в конце марта. То есть это не какой-то фоновый шум, который был всегда и я просто не замечал, а конкретная, довольно свежая волна активности, начавшаяся резко и без предупреждения.
Полез искать хоть какую-то логику в самих адресах — может, это часть большого пути, может, следы старого редиректа, может, случайно порезанная ссылка. Ничего внятного не нашёл, кроме одной закономерности: у всех этих адресов совпадают первые пять символов, дальше идёт уже случайный хвост разной длины. Такая структура — это по сути подпись, идентификатор партии, а не случайность. Кто-то генерировал эти адреса пачками, одним и тем же скриптом или сервисом, и явно не для одного моего сайта, а массово, для целой пачки чужих доменов разом. Обычная история с такими штуками — это либо проверка сайтов на уязвимости (боту всё равно, есть там дыра или нет, он просто перебирает миллион вариантов на миллионе сайтов и смотрит, где повезёт), либо забивание чужого краулингового бюджета мусором, либо ещё какая-то форма спама, смысл которой мне, честно говоря, до конца не ясен, да и не так уж важен.
Дальше стало интереснее. Начал разбираться, а как вообще Яндекс узнал про существование этих адресов, если на сайте на них никто и никогда не ссылался, в карте сайта их тоже, разумеется, нет. И вот тут всплыла деталь, о которой я, признаться, раньше даже не задумывался: у Яндекса есть механика, когда счётчик статистики, установленный на сайте, служит источником для поиска новых страниц под сканирование. Логика на первый взгляд удобная — если счётчик зафиксировал посещение какой-то страницы, значит, страница реальная и её стоит проиндексировать, даже если формальных ссылок на неё нигде нет. Проблема в том, что номер счётчика — штука публичная, он торчит в коде каждой страницы сайта открытым текстом, иначе просто не смог бы работать. А раз он публичный, значит, отправить этому счётчику фальшивый сигнал "тут было посещение вот такой-то страницы" можно вообще без реального захода на сайт — просто дёрнув соответствующий адрес счётчика напрямую, подставив туда любой произвольный путь. Никакого браузера, никакой реальной загрузки страницы, ни капчи, ничего — чистый программный запрос, который выглядит как честный визит, потому что механизм на своей стороне никак не проверяет, была ли страница действительно кем-то открыта.
Вот и получается забавная, если так можно выразиться про собственную головную боль, картина: некто массово скармливает счётчику вымышленные визиты на вымышленные страницы, счётчик честно всё записывает, а Яндекс, доверяя собственным данным, отправляет робота проверять эти страницы, а заодно щедро закидывает их в индекс, раздувая цифру, которая изначально меня и насторожила. То есть источник дыры — не сайт и не его код, а собственный механизм поисковика, который слишком доверчиво относится к данным своей же аналитики. При этом что показательно, у другого крупного поисковика точно такой же проблемы не возникает, просто потому что у него физически нет доступа к сырым данным этого счётчика — соответственно, и подделывать там нечего, и мусора там нет вообще ни строчки.
Разобравшись с механизмом, оставалось решить, что со всем этим делать практически. Первая мысль была банальная — закрыть эти пути через файл с директивами для роботов, благо строчка добавляется за пять секунд. Быстро выяснилось, что толку от этого немного: такая директива работает только на добросовестных роботов, которые её вообще читают и уважают, а источник мусора — это не сам поисковый робот, а сторонний скрипт, подделывающий сигналы счётчику, и на подобные инструкции ему совершенно наплевать, он их даже не запрашивает. То есть новый мусор эта мера не предотвращает вообще никак, разве что не даёт уже честному роботу поисковика заходить туда повторно, но это, как говорится, тушим не тот пожар.
Реально работающий вариант оказался куда более приземлённым — правило прямо на уровне веб-сервера, которое перехватывает такие запросы ещё до того, как они вообще доходят до движка сайта, и сразу отдаёт код ответа, означающий "этого не существует и не будет существовать никогда", в отличие от обычного "не найдено", которое поисковик воспринимает как временное состояние и норовит перепроверить снова и снова. Разница тонкая, но принципиальная: один код говорит "может, попозже появится", другой — "закрывайте вопрос окончательно".
Добавляется это буквально одной строчкой в файл настроек сервера, самым первым правилом, ещё до основной маршрутизации движка:
RewriteEngine On

RewriteRule ^9fa50 - [G,L]
Флаг в квадратных скобках означает две вещи разом — "Gone" (тот самый код "уже не существует") и "Last" (сервер останавливает обработку правил на этом месте и дальше не идёт). То есть если путь начинается с подозрительного набора символов — сервер сразу отвечает и не тратит время на попытку загрузить движок сайта, обратиться к базе данных или сделать что-то ещё. Проверить результат просто — открыть в браузере любой адрес с этим началом пути, должен прилететь код ответа 410, а не привычный 404.
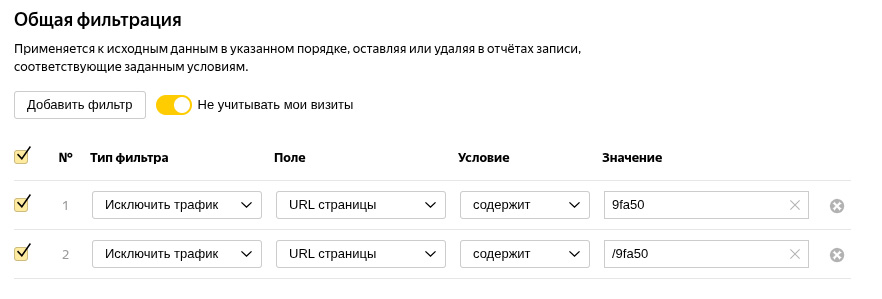
С самим счётчиком аналитики ситуация чуть сложнее — там, к сожалению, нет простого способа заблокировать конкретно поддельные запросы, идущие напрямую к его серверам, минуя сайт. Единственное, что удалось сделать на этой стороне — зайти в настройки самого счётчика, найти там раздел с фильтрами (у Метрики это отдельный пункт в настройках счётчика, где можно включить расширенную фильтрацию роботов и настроить фильтры по отдельным URL или параметрам), и почистить хотя бы статистику посещаемости, чтобы этот мусор не портил реальные цифры по трафику. На сам факт появления фальшивых визитов это никак не влияет — запросы к серверам счётчика всё равно продолжают долетать и обрабатываться, просто из отчётов, на которые я смотрю каждый день, лишние строчки исчезают. То есть это лечение симптома в собственной статистике, а не самой причины — но и то хлеб, раз повлиять на саму механику приёма данных со стороны обычного пользователя счётчика невозможно.
В остатке имеем занятную, хоть и не самую приятную историю: чужой скрипт нашёл слабое место не в конкретном сайте, а в самой логике популярного поискового движка, и через эту дыру можно годами капать мусором в чужую статистику сканирования, а разбираться с последствиями приходится каждому вебмастеру индивидуально, потому что сам виновник проблемы предпочитает эту проблему не признавать. Осадок, конечно, остаётся — но хотя бы теперь понятно, откуда ноги растут, а не просто разводить руками, глядя на очередную порцию бессмысленных строчек в отчёте.
